機器視覺與多軸運動控制,是所有工業負載里對內存“既要帶寬、又要確定性”的典型矛盾體。很多人以為視覺吃帶寬、運動吃算力,其實兩者最終都會匯聚到同一個瓶頸——內存子系統的訪問抖動。這個抖動看不見,卻直接寫在良率曲線上。
先拆視覺側。以 4K@30fps 10bit 采集為例,單幀原始數據約 11MB,雙緩沖就要 22MB,OpenCV 特征金字塔、形態學算子還會再申請臨時內存,實測峰值經常沖到單幀三倍多。如果是 4 路相機同步采集,幀緩存區輕松占掉幾個 GB。好在這類流式訪存對延遲不敏感、對帶寬極度敏感,CPU 硬件預取能很好地掩蓋 CL 延遲,所以工程上 DDR4-2666 CL19 實測 Copy 帶寬 42GB/s 量級,和 3200 檔的差距遠小于紙面頻率差。深圳聯樂實業給一家面板 AOI 設備做升級時,原平臺單通道
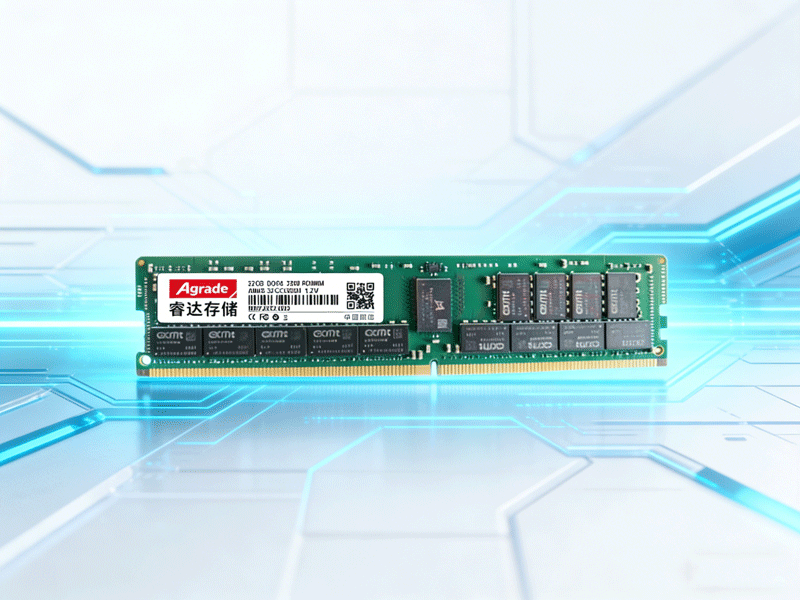
8GB 消費條,圖像流水線經常因為內存換頁出現幀間間隔毛刺;換成 Agrade 睿達工業 DDR4-2666 ECC UDIMM 雙通道 16GB×2 后,雙緩沖切換零丟幀,算法線程調度方差收窄明顯。
但運動控制完全是另一套邏輯。六軸機械臂的軌跡插補、伺服周期 1kHz 甚至 4kHz 的中斷閉環,要求的是“每一次中斷響應時間方差極小”。問題出在哪?操作系統定時器中斷觸發后,如果發生 L2 cache miss,要從 DRAM 回填,一次回填就可能引入數個微秒的尾巴延遲;再加上內存刷新窗口、Bank Group 仲裁,抖動就被放大了。業界硬實時方案往往把關鍵軌跡表鎖進末級緩存甚至片上 SRAM,但上下文和共享狀態仍要走 DDR。降低抖動的可行手法,聯樂現場驗證過三條:關 BIOS 里 Package
C-State 深度節能避免動態提頻降頻、把內存頻率鎖定不隨 P-state 漂移、用 hugepage 減少 TLB miss。三管齊下,能把中斷響應方差壓下一個數量級。
共享內存架構在這里很關鍵。現在主流 PCIe 視覺采集卡、伺服通信卡走統一內存映射,DMA 直接寫環形緩沖到主機 DDR4,伺服核原地消費,全程零拷貝。這條鏈路上任何一次內存 ECC 糾錯事件、任何一次 CE 上報,都會輕微擾動 DMA 調度。有公開統計,非 ECC 工控機一年因軟錯誤引發異常重啟的比例能到兩位數,ECC 機型可以壓到百分之一以內。這個數據,就是醫療影像、精密點膠、激光振鏡這類高精度設備必須上 ECC DDR4 的硬證據。
再講一個常被低估的點:NVMe 日志與內存的耦合。視覺軟件如 VisionPro 每秒產生大量日志,日志先落內存緩沖再刷盤,內存帶寬被日志沖刷時也會擠占圖像通路。聯樂通常建議系統盤用 Agrade 睿達工業 NVMe SSD 承接高并發日志寫入,把 DRAM 留給幀緩沖和算子張量,存儲與內存分工清晰,不搶資源。這也是聯樂“內存+SSD”成套交付方案在現場特別順手的原因——一套供應商、一套可靠性規范、一套 PCN 口徑。
建模選型上給個落地結論:4 路以內 500 萬像素級視覺,雙通道 DDR4-2666 ECC UDIMM 16×2 足夠;8 路以上或疊加 3D 點云,上 32GB×2 并確認雙通道跑滿;運動控制主機不追高頻,穩 2400/2666、鎖頻、開 ECC,比追 3200 有意義得多。深圳聯樂實業可按相機路數、伺服軸數、實時操作系統(RT-Linux / INtime / Xenomai)做一對一內存參數收斂調優,把“紙面規格”翻譯成產線上的穩定節拍。